 Tài liệu học xây kênh
Cách dựng video YouTube dài từ giọng đọc có sẵn (không cần biết edit)
Bạn đã có kịch bản và file giọng đọc cho một tập 15–25 phút, nhưng mở phần mềm dựng phim lên là bế tắc. Bài này đi thẳng vào cách dựng video YouTube từ giọng đọc có sẵn: chia cảnh khớp lời kể, lập danh sách ảnh, làm phụ đề, canh âm lượng chuẩn YouTube và xuất MP4 — kể cả khi bạn chưa từng dùng Premiere hay CapCut.
Bài toán thật sự khi bạn đã có sẵn giọng đọc
Đa số hướng dẫn trên mạng bắt đầu từ chỗ khác bạn: nhập chủ đề hoặc dán kịch bản, để công cụ tự sinh giọng AI rồi ghép hình. Nhưng người làm kênh faceless nghiêm túc thường đã có giọng đọc riêng — tự thu bằng micro, hoặc dùng TTS với một giọng cố định để khán giả nhận ra kênh. Lúc đó giọng đọc là thứ không được đụng vào: nó quyết định nhịp kể, chỗ ngắt, chỗ lặng. Việc còn lại là dựng hình bám theo nó.
Sự khác biệt này rất quan trọng. Khi giọng đọc sinh sau, phần mềm có thể co giãn câu chữ cho vừa hình. Khi giọng đọc có trước, bạn phải làm ngược: hình phải chạy theo lời. Mỗi lần người đọc nhắc tới "năm 1978", "chiếc xe màu đỏ", "biểu đồ dân số", khung hình tại đúng giây đó phải thể hiện được điều ấy. Lệch 3–4 giây thôi là khán giả cảm thấy video "trôi", dù không chỉ ra được vì sao.
Với video dài 15–25 phút, đây là công việc có khối lượng thật. Nếu mỗi cảnh trung bình 8–12 giây, một tập 19 phút cần khoảng 95–140 khung hình khác nhau (con số ước lượng, tuỳ nhịp kể). Đó là 95–140 lần bạn phải quyết định: đoạn này nói gì, cần ảnh gì, lấy ảnh ở đâu, đặt vào giây thứ mấy, giữ bao lâu.
Tin tốt: bạn không cần biết dựng phim theo nghĩa chuyên nghiệp. Video faceless kể chuyện bằng giọng đọc không cần transition cầu kỳ, không cần color grading, không cần motion graphics phức tạp. Nó cần đúng ba thứ: hình khớp lời, phụ đề sạch, âm thanh nghe rõ và đủ to. Phần còn lại là quy trình — mà quy trình thì học được trong một buổi.
Chuẩn bị trước khi mở phần mềm dựng
90% cảnh "dựng mãi không xong" đến từ việc bắt đầu quá sớm. Trước khi kéo file vào timeline, hãy làm cho xong bộ nguyên liệu dưới đây. Mỗi phút bỏ ra ở bước này tiết kiệm 5–10 phút ở khâu ghép hình.
- File giọng đọc bản cuối — đã cắt hết chỗ vấp, đã thống nhất tốc độ đọc. Tuyệt đối không dựng trên bản nháp rồi thay audio sau, vì thay audio là toàn bộ timeline lệch.
- Kịch bản khớp với file audio — đúng từng câu người đọc đã đọc. Nếu lúc thu bạn có sửa lời, phải sửa lại vào file kịch bản. Kịch bản lệch audio sẽ phá vỡ mọi bước chia cảnh phía sau.
- Thư mục dự án gọn gàng — một thư mục cho mỗi tập, bên trong tách
audio,anh,clip,xuat. Nghe rất vặt vãnh, nhưng khi có 120 file ảnh thì đây là thứ giữ bạn khỏi mất 20 phút chỉ để tìm một tấm hình. - Quy ước đặt tên file — đặt theo số cảnh:
c001_pho-co.jpg,c002_ban-do.jpg. Khi kéo vào timeline, file tự sắp đúng thứ tự, đỡ hẳn khâu dò tìm. - Kho tư liệu riêng của bạn — ảnh tự chụp, screenshot tài liệu, bản đồ, ảnh tư liệu miễn phí bản quyền. Đây là thứ khiến kênh bạn trông khác kênh khác, đừng bỏ qua vì nghĩ "không đẹp bằng ảnh AI".
Về phần mềm: bạn không cần mua gì để bắt đầu. Trên Windows có sẵn Clipchamp; ngoài ra CapCut bản máy tính và DaVinci Resolve bản miễn phí đều dựng được video dài 1080p. Điểm chung là cả ba đều làm được ba việc tối thiểu: kéo audio vào một track, thả ảnh lên track phía trên, và xuất MP4. Nếu bạn mới hoàn toàn, có thể tham khảo thêm bộ công cụ cần thiết cho người làm YouTube không lộ mặt để khỏi cài lan man.
Lưu ý: tốc độ đọc ảnh hưởng trực tiếp tới số cảnh. Giọng đọc chậm, nhiều khoảng lặng thì mỗi cảnh giữ được lâu hơn, số ảnh cần ít hơn. Giọng đọc nhanh, dồn dập thì phải đổi hình dày hơn nếu không muốn người xem chán.
Quy trình dựng thủ công 8 bước, không cần biết edit
Đây là quy trình tối giản nhưng đủ dùng cho một tập faceless dài. Làm đúng thứ tự, đừng nhảy cóc.
Bước 1 — Nghe hết file một lượt và ghi timecode
Mở file audio, nghe từ đầu tới cuối, mỗi lần người đọc chuyển ý thì ghi lại mốc thời gian vào file kịch bản (ví dụ 03:12 — bắt đầu nói về gia đình nạn nhân). Bạn sẽ có một bộ khung 15–25 mốc lớn cho cả tập. Đừng bỏ bước này: nó là bản đồ để bạn không bị lạc khi timeline dài 19 phút.
Bước 2 — Chia kịch bản thành cảnh
Trong mỗi mốc lớn, cắt tiếp thành các cảnh 8–12 giây theo đơn vị ý, không cắt giữa câu. Một cảnh = một ý người đọc đang nói. Đánh số cảnh liên tục từ đầu tới cuối tập.
Bước 3 — Viết danh sách ảnh cần có
Với mỗi cảnh, viết một dòng mô tả hình cần có: chủ thể, bối cảnh, góc máy, thời kỳ. Ví dụ: "cảnh 27 — con phố châu Âu thập niên 1960, trời mưa, nhìn từ xa". Danh sách này chính là đơn đặt hàng của bạn cho bước tìm ảnh.
Bước 4 — Gom đủ hình
Ưu tiên ảnh tư liệu thật và kho ảnh riêng trước; phần nào không có mới tạo bằng AI. Làm theo lô: đọc hết danh sách rồi tìm/tạo một mạch, đừng vừa dựng vừa tìm ảnh — chuyển qua chuyển lại giữa hai đầu việc là thứ làm mất thời gian nhiều nhất.
Bước 5 — Kéo audio vào timeline rồi thả hình
Đặt file giọng đọc vào track dưới cùng và khoá nó lại. Mọi thao tác sau đó chỉ diễn ra ở track hình. Thả ảnh theo đúng thứ tự cảnh, kéo dài/ngắn từng ảnh cho khớp đoạn lời tương ứng.
Bước 6 — Thêm chuyển động nhẹ cho ảnh tĩnh
Ảnh đứng yên 10 giây sẽ khiến video chết hình. Áp một chuyển động zoom chậm hoặc trượt ngang rất nhẹ cho mỗi ảnh. Đổi chiều chuyển động xen kẽ để không bị đều đều một nhịp.
Bước 7 — Phụ đề
Tạo phụ đề tự động trong phần mềm rồi dò lại bằng tay, đặc biệt tên riêng, năm, số liệu. Giữ mỗi dòng ngắn, đặt ở vùng an toàn phía dưới nhưng đừng sát đáy (tránh bị thanh thời lượng của YouTube che).
Bước 8 — Nhạc nền, cân âm lượng, xuất file
Nhạc nền để rất nhỏ, chỉ đủ lấp khoảng trống. Sau đó cân âm lượng tổng (xem phần bên dưới) và xuất MP4 1080p, 24 hoặc 30 hình/giây.
8 bước dựng video dài từ giọng đọc có sẵn, làm thủ công.
Ba khâu ngốn thời gian nhất và cách rút ngắn
Dựng một tập 15–20 phút bằng tay mất bao lâu? Dưới đây là khoảng ước lượng phổ biến cho một người làm quen tay, một mình, với tập khoảng 19 phút. Người mới có thể gấp rưỡi tới gấp đôi.
| Công đoạn | Thời gian ước lượng | Vì sao tốn |
|---|---|---|
| Nghe lại giọng đọc, ghi timecode, chia cảnh | 60–90 phút | Phải nghe gần như thời gian thực, tua đi tua lại |
| Viết danh sách ảnh cần có | 30–45 phút | Hơn trăm dòng mô tả, phải nhớ mạch truyện |
| Tìm và tạo 100–140 hình | 90–180 phút | Khâu dễ sa đà nhất, tìm một ảnh mất 1–2 phút là bình thường |
| Ghép hình vào timeline, canh độ dài từng cảnh | 60–120 phút | Thao tác lặp lại hàng trăm lần |
| Phụ đề và dò lỗi chính tả | 45–90 phút | Tên riêng, số liệu, thuật ngữ luôn sai |
| Nhạc nền, cân âm lượng, xuất, kiểm tra | 20–40 phút | Xuất xong phát hiện lỗi là phải làm lại |
Tổng lại thường rơi vào 5–9 tiếng cho một tập. Nếu bạn muốn ra 2 tập/tuần, riêng khâu dựng đã ăn gần trọn hai ngày làm việc — chưa tính nghiên cứu và viết kịch bản.
Ba chỗ nặng nhất luôn là: (1) nghe lại giọng đọc để cắt cảnh, (2) tìm ảnh khớp đúng đoạn đang kể, (3) canh phụ đề cho sạch. Mẹo giảm tải nếu vẫn làm tay:
- Làm theo lô, không làm theo cảnh — chia cảnh cho cả tập xong hẳn, rồi mới tìm ảnh cho cả tập, rồi mới ghép. Mỗi lần đổi loại việc, não bạn mất vài phút để vào nhịp lại.
- Dùng transcript có timecode — nếu công cụ tạo phụ đề của bạn xuất được file SRT, hãy xuất ra trước, đọc file đó thay vì nghe lại audio. Đọc nhanh hơn nghe khoảng 3 lần.
- Lập kho ảnh dùng lại giữa các tập — bản đồ, nền giấy cũ, texture, ảnh chuyển đoạn. Không phải cảnh nào cũng cần ảnh mới tinh.
- Chốt template một lần — font phụ đề, vị trí, màu, kiểu chuyển cảnh. Chốt xong thì tập nào cũng dùng lại, đừng nghĩ lại từ đầu mỗi lần.
Làm sao để ảnh khớp lời kể, không lặp, không na ná kênh khác
Đây là khác biệt giữa một video faceless xem được và một video "trình chiếu ảnh có giọng đọc". Cùng một kịch bản, cùng một giọng, nhưng chọn hình khác nhau thì retention khác hẳn.
Nguyên tắc một cảnh — một ý
Khung hình phải minh hoạ đúng cái người đọc đang nói ở giây đó, không phải cái đã nói 20 giây trước. Cách kiểm tra nhanh: tắt tiếng, tua ngẫu nhiên 5 chỗ trong video, nhìn hình và đoán xem đoạn này đang kể gì. Đoán trúng 4/5 là ổn.
Đổi cỡ cảnh để mắt không chán
Đừng để 10 ảnh liên tiếp cùng một kiểu bố cục. Luân phiên: toàn cảnh (bối cảnh, địa điểm) → trung cảnh (nhân vật, đồ vật) → cận cảnh (chi tiết, bàn tay, tài liệu) → hình đồ hoạ (bản đồ, dòng thời gian, biểu đồ). Nhịp thay đổi này là thứ người xem cảm nhận được dù không phân tích được.
Dùng đồ hoạ số liệu thay vì đọc số suông
Khi giọng đọc nói "dân số tăng từ 2 triệu lên 9 triệu trong 30 năm", đưa một biểu đồ cột hoặc dòng thời gian lên màn hình có sức giữ chân hơn hẳn một tấm ảnh thành phố chung chung. Với các ngách tài liệu, khoa học, tiểu sử, đây là điểm nâng chất lượng rẻ nhất mà nhiều kênh bỏ qua.
Tránh vòng lặp ảnh
Lỗi hay gặp ở video dài: đến phút 12 hết ý tưởng, bắt đầu dùng lại những tấm ảnh của phút 3. Khán giả nhận ra ngay và hiểu là bạn đang "kéo dài". Cách phòng: khi viết danh sách ảnh ở bước 3, đánh dấu những ảnh đã dùng; nếu buộc phải dùng lại, hãy đổi cỡ cắt (crop cận vào một chi tiết khác) để nó thành một khung hình mới.
Làm cho kênh bạn khác kênh khác
Các kênh trông na ná nhau thường vì cùng dùng một kho ảnh stock phổ biến và một template mặc định. Hai cách thoát: thứ nhất, chèn tư liệu riêng (ảnh bạn tự chụp, tài liệu bạn tự scan, bản đồ bạn tự vẽ) dù chỉ 10–20% tổng số cảnh; thứ hai, khoá một phong cách hình nhất quán cho cả kênh — cùng tông màu, cùng kiểu khung, cùng font phụ đề. Nguyên tắc giữ đồng nhất này khá giống với cách giữ nhân vật đồng nhất khi làm video AI: khán giả nhận ra kênh bằng cảm giác thị giác trước khi nhận ra bằng nội dung.
Phụ đề và âm lượng chuẩn YouTube — hai thứ hay bị bỏ qua
Phụ đề tự động của YouTube có đủ dùng không?
Câu trả lời thẳng: dùng tạm được, nhưng không nên dựa hẳn. Phụ đề tự động sai khá thường xuyên với tên riêng, thuật ngữ, số năm, và sai nhiều hơn khi giọng đọc có tạp âm hoặc phát âm vùng miền. Chính YouTube cũng khuyến nghị người đăng tự thêm phụ đề chuẩn và kiểm tra lại bản tự động. Với kênh faceless, phụ đề còn quan trọng hơn bình thường vì lượng lớn người xem mở video ở chế độ tắt tiếng hoặc trong môi trường ồn.
Có hai loại phụ đề, đừng nhầm: phụ đề nung vào hình (burned-in, nằm sẵn trong file MP4) và file phụ đề tải lên YouTube (SRT, khán giả bật/tắt được). Với video kể chuyện dài, nung phụ đề vào hình giúp kiểm soát hoàn toàn font, vị trí, nhịp hiện chữ; còn tải kèm SRT giúp YouTube hiểu nội dung. Làm được cả hai là tốt nhất.
Âm lượng: con số −14 LUFS
Đây là phần gần như không bài hướng dẫn faceless nào nhắc tới, nhưng ảnh hưởng trực tiếp tới trải nghiệm xem. YouTube chuẩn hoá âm lượng về mức ưu tiên khoảng −14 LUFS. Nếu video của bạn to hơn mức đó, nền tảng sẽ tự vặn nhỏ xuống. Ví dụ file của bạn ở −10 LUFS, YouTube hạ khoảng 4 dB để đưa về mức chuẩn.
Điểm cần nhớ: YouTube chỉ giảm chứ không tăng. Nội dung nhỏ hơn −14 LUFS được giữ nguyên ở mức gốc. Nghĩa là nếu bạn xuất file với giọng đọc quá nhỏ, video của bạn sẽ nghe yếu hơn hẳn các kênh cùng ngách, người xem phải vặn loa lên — và họ thường không vặn, họ bấm thoát.
Cách kiểm tra sau khi đăng: bấm chuột phải vào video đang phát, chọn Stats for Nerds, lớp phủ hiện ra sẽ cho biết mức chuẩn hoá âm lượng mà YouTube đang áp cho video đó. Nếu thấy nền tảng đang hạ nhiều dB, tập sau nên xuất nhẹ hơn.
Mỗi nền tảng một chuẩn khác nhau — các dịch vụ phim như Netflix, Disney+ hay Prime Video làm việc quanh mức −27 đến −24 LUFS. Đừng mang thông số từ hướng dẫn làm phim sang áp cho YouTube, vì lệch hơn 10 dB là chuyện bình thường.
Tự động hoá phần nặng nhất khi bạn không biết edit
Sau khi đọc tới đây, bạn thấy rõ: quy trình không khó hiểu, nhưng nặng về khối lượng. Ba khâu ăn giờ nhất — nghe lại giọng đọc để cắt cảnh, tìm ảnh khớp lời, canh phụ đề — đều là việc lặp lại có quy tắc. Mà việc lặp lại có quy tắc thì máy làm được.
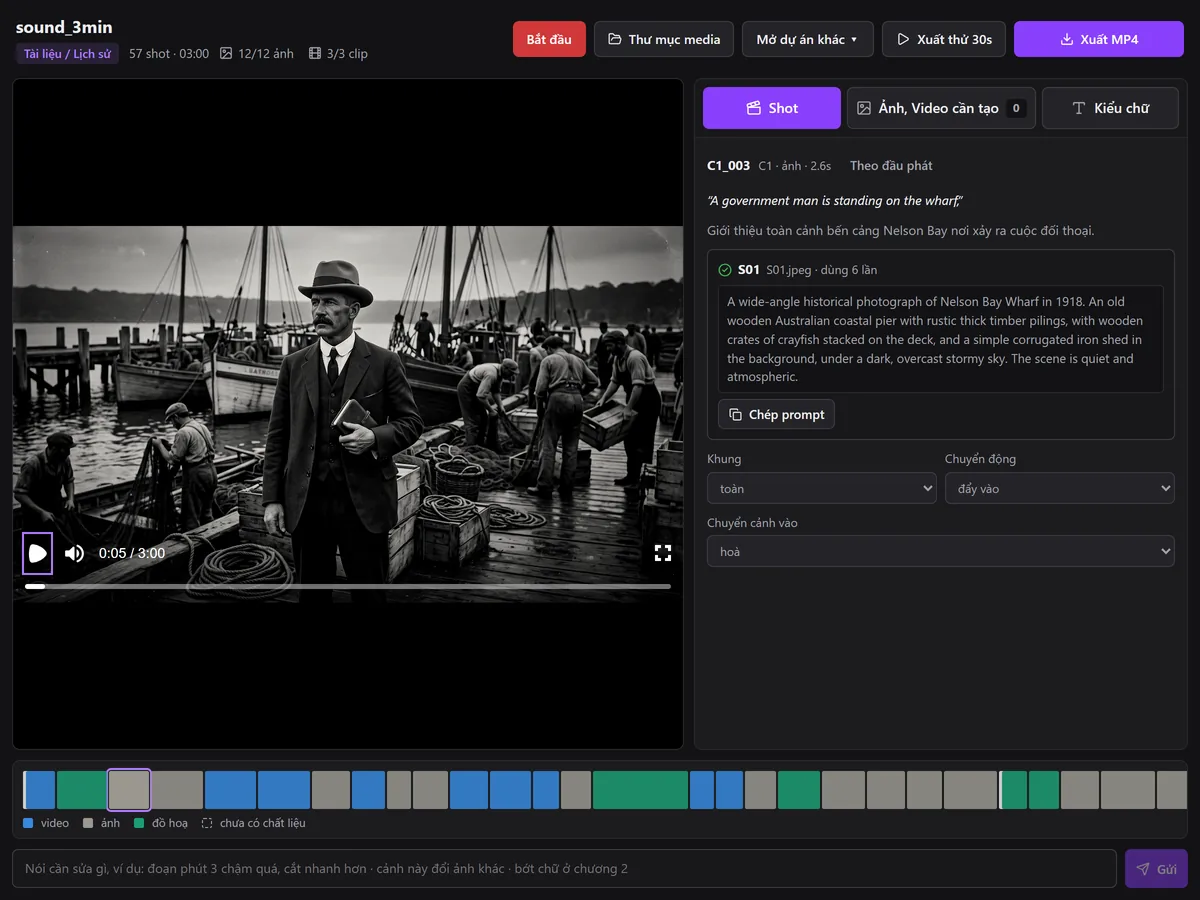
Đây chính là chỗ DC23 AI Studio được làm ra để giải quyết. Đó là một app chạy trên Windows, nhận vào đúng hai thứ bạn đã có sẵn: file giọng đọc và kịch bản. AI sẽ chia cảnh khớp với lời kể, xuất ra danh sách ảnh cần có cho từng cảnh, tự làm phụ đề và dựng đồ hoạ số liệu, rồi xuất MP4 1080p đã chuẩn âm lượng YouTube. Muốn sửa gì — đổi ảnh, gộp cảnh, chỉnh chữ — bạn chat bằng tiếng Việt thay vì đi học phần mềm dựng phim. Ảnh và clip bạn tự có vẫn dùng được, nên phần tư liệu riêng làm nên bản sắc kênh không bị mất đi.
Về chi phí — câu hỏi mà rất ít hướng dẫn trả lời thẳng: app dùng API key kie.ai riêng của bạn, nên bạn thấy được hoá đơn thật của mình chứ không phải đoán. Phần phân tích một tập khoảng 19 phút tốn chừng 0,4–0,5 USD. Biết con số này giúp bạn tính được giá vốn mỗi tập trước khi bấm nút, thay vì làm xong mới ngỡ ngàng. Nếu muốn nhìn tổng thể các khoản chi khi làm video bằng AI, đọc thêm làm video AI cho YouTube tốn bao nhiêu tiền.
Cũng cần nói rõ app không làm gì, để bạn khỏi kỳ vọng sai: không viết kịch bản, không tạo giọng đọc, không làm tiêu đề — mô tả — thumbnail, và không đăng YouTube. Nó chỉ làm đúng khâu dựng. Phần nội dung và giọng vẫn là của bạn — và đó cũng chính là phần quyết định kênh có khác biệt hay không. Chi tiết thao tác từ cài đặt tới lúc xuất file có trong hướng dẫn dùng DC23 AI Studio.
Câu hỏi thường gặp
- Không biết edit thì có dựng được video dài không? — Được. Video faceless kể chuyện không cần kỹ thuật dựng phức tạp; thứ nó cần là hình khớp lời, phụ đề sạch và âm thanh chuẩn. Ba thứ này đều là quy trình, không phải năng khiếu.
- Có bắt buộc dùng ảnh AI không? — Không. Ảnh tư liệu, ảnh tự chụp, screenshot tài liệu, bản đồ đều dùng tốt và thường làm video khác biệt hơn. Ảnh AI nên dùng cho những cảnh không thể tìm được tư liệu thật.
- Làm sao biết một cảnh nên giữ bao lâu? — Theo lời kể, không theo đồng hồ. Cảnh kết thúc khi ý đang nói kết thúc. Khoảng 8–12 giây là vùng an toàn cho giọng đọc tốc độ trung bình, nhưng đoạn cao trào có thể đổi hình nhanh hơn.
- Thay file giọng đọc sau khi đã dựng xong thì sao? — Toàn bộ timeline lệch và gần như phải làm lại. Vì vậy chỉ dựng trên bản audio cuối cùng.
- Nhạc nền để to bao nhiêu? — Đủ nhỏ để không làm khó nghe giọng đọc. Nguyên tắc thực dụng: nghe thử bằng điện thoại loa ngoài, nếu phải cố tập trung mới nghe rõ lời thì nhạc đang to quá.
- Nên xuất định dạng nào? — MP4, 1080p, 24 hoặc 30 hình/giây là đủ cho nội dung ảnh tĩnh + đồ hoạ. Lên 4K không cải thiện gì đáng kể với loại video này mà file nặng hơn nhiều.
- Ra được bao nhiêu tập một tuần là hợp lý? — Chọn tần suất bạn duy trì được ít nhất vài tháng, thay vì bung sức tuần đầu rồi tắt. Nếu đang phân vân nên ưu tiên việc gì trước, xem phân cấp ưu tiên công việc khi xây kênh faceless.
Đọc thêm: Chọn ảnh minh hoạ khớp lời kể cho video faceless · Làm phụ đề tự động tiếng Việt không bị lệch giờ · Làm đồ hoạ số liệu, timeline cho video tài liệu
Kết luận
Tóm lại, cách dựng video YouTube từ giọng đọc có sẵn không nằm ở việc học một phần mềm cao siêu, mà ở việc làm đúng thứ tự: nghe và chia cảnh trước, viết danh sách ảnh, gom hình theo lô, ghép vào timeline khoá audio, làm phụ đề sạch, rồi cân âm lượng quanh mức −14 LUFS trước khi xuất MP4 1080p. Làm tay được, chỉ là mất khoảng 5–9 tiếng cho mỗi tập 15–20 phút.
Nếu bạn muốn giữ nguyên giọng đọc và kịch bản của mình nhưng bỏ được phần nặng nhất, DC23 AI Studio làm đúng khúc đó: nhận giọng đọc + kịch bản có sẵn, AI chia cảnh khớp lời kể, ra danh sách ảnh cần có, tự làm phụ đề và đồ hoạ số liệu, sửa bằng chat tiếng Việt, xuất MP4 1080p chuẩn âm lượng YouTube, dùng được ảnh/clip bạn tự có. App có bản dùng thử, sau đó kích hoạt bằng mã; ai đang còn hạn key DC23 cũ thì mở thẳng bản Pro.
Nhắn Zalo cho DC23 Media để nhận bản cài và được hướng dẫn dựng thử ngay chính file giọng đọc bạn đang có. Muốn đọc thêm trước khi quyết, ghé mục Tài liệu.
Có sẵn giọng đọc rồi mà vẫn kẹt ở khâu dựng?
Nhắn Zalo cho DC23 Media để nhận bản cài DC23 AI Studio và dùng thử — mang đúng file giọng đọc và kịch bản của bạn vào dựng thử một tập.
Nhắn Zalo nhận mã dùng thử →